Z-Image-Turbo使用教程
- 笔记
- 2026-08-07
- 157热度
- 0评论
Z-Image-Turbo 是一个少步数文生图模型。它能理解中文提示词,生成速度快,尤其适合用来学习 ComfyUI 的完整文生图流程。
这篇教程会从下载模型开始,一步一步搭好正确的工作流,然后再解释每个参数为什么这样设置。你不需要先懂扩散模型,也不需要记住复杂公式。先照着做出第一张图,再回头理解原理,会轻松很多。
一、下载模型
1. 模型文件
Z-Image-Turbo 的 ComfyUI 版本采用“分离式”结构。它不像某些 Stable Diffusion Checkpoint 那样,把所有部件装在一个文件里,而是把三个角色分开保存:
| 文件 | 可以理解成 | 实际作用 | 大约大小 | 存放目录 |
| z_image_turbo_bf16.safetensors | 画师 | 从噪声中生成图像 | 12.3 GB | ComfyUI/models/diffusion_models/ |
| qwen_3_4b.safetensors | 翻译员 | 把中文或英文提示词转换成模型能理解的数字条件 | 8.04 GB | ComfyUI/models/text_encoders/ |
| ae.safetensors | 显影器 | 在潜空间数据与可见图片之间转换 | 335 MB | ComfyUI/models/vae/ |
三个文件合计约 20.7 GB。
2. 下载方法
打开魔搭社区的 Comfy-Org/z_image_turbo 模型页面,进入“模型文件”或“文件与版本”页面。
依次找到下面三个路径,只下载对应文件:
split_files/
├─ diffusion_models/
│ └─ z_image_turbo_bf16.safetensors
├─ text_encoders/
│ └─ qwen_3_4b.safetensors
└─ vae/
└─ ae.safetensors
进入文件详情后点击下载即可。模型文件很大,浏览器看起来长时间没有变化时,不要重复点击下载;先检查浏览器的下载列表是否仍在传输。
3. 放入正确目录
下载完成后,将文件放成下面这样:
ComfyUI/
└─ models/
├─ diffusion_models/
│ └─ z_image_turbo_bf16.safetensors
├─ text_encoders/
│ └─ qwen_3_4b.safetensors
└─ vae/
└─ ae.safetensors
如果 ComfyUI 在模型下载前已经打开,放好文件后需要刷新模型列表或重新启动 ComfyUI,新的文件名才会出现在下拉菜单里。
二、从零搭建 Z-Image-Turbo 工作流
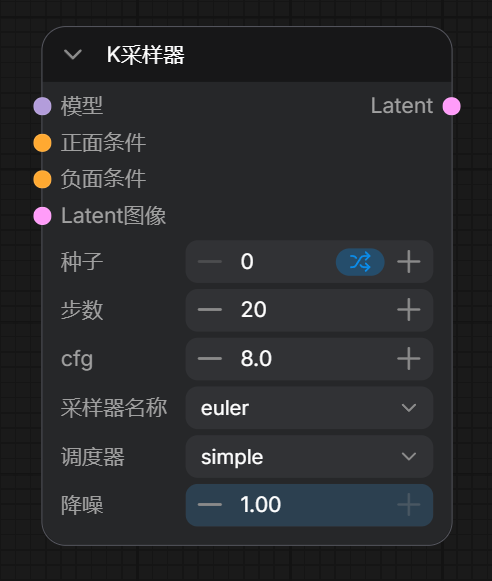
第 1 步:添加 KSampler
在 ComfyUI 画布空白处双击,搜索:
KSampler
中文界面通常显示为“K采样器”。它是整个生成过程的调度中心。
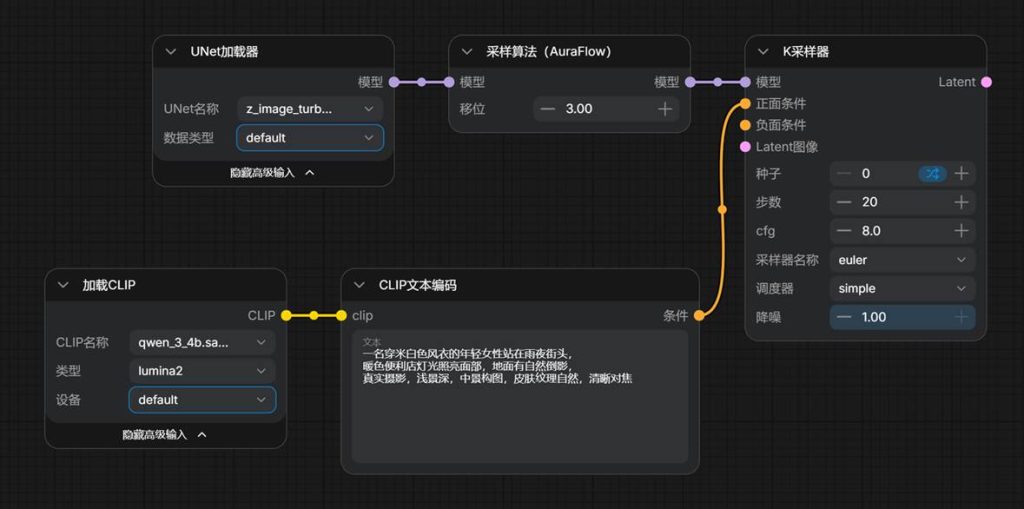
第 2 步:加载主模型
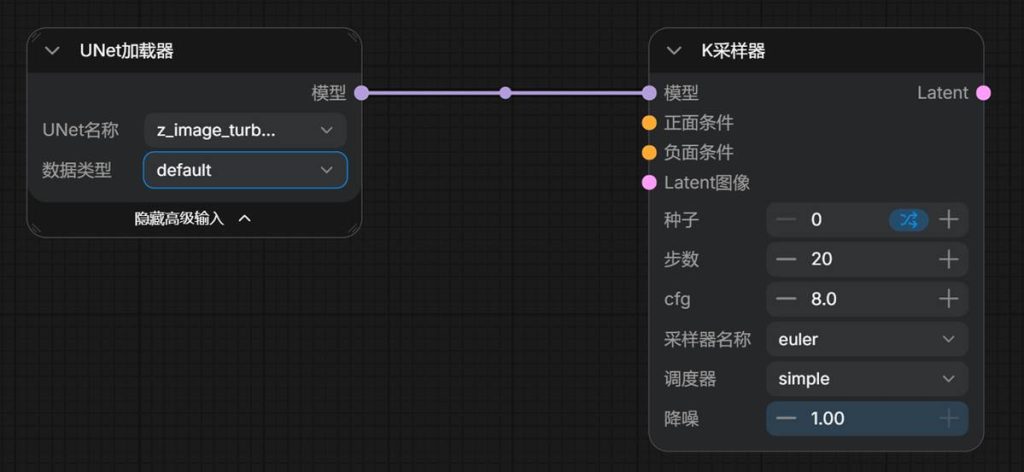
从 KSampler 左侧的“模型”接口向外拖一条线,搜索:
UNet加载器(UNET Loader)
这个节点主要是加载负责去噪生成的主模型。
在模型下拉菜单中选择:
z_image_turbo_bf16.safetensors
数据类型(显示高级输入里)保持 default 即可。
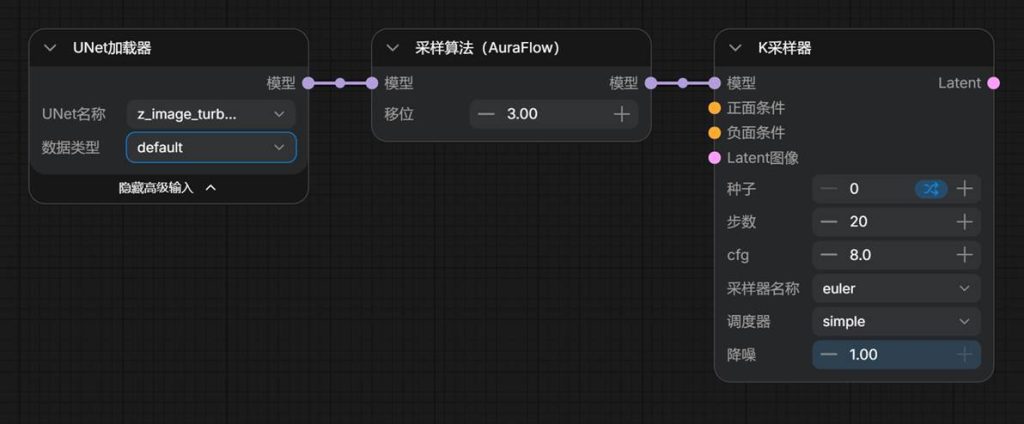
接下来在UNet加载器和KSampler之间,搜索并添加“采样算法”节点:
ModelSamplingAuraFlow
将 shift 设置为 3。
第 3 步:加载文本编码器
接下来为K采样器添加“放提示词的节点”
从K采样器的正向条件拉出一条线,选择
CLIP文本编码(或者CLIP Text Encode)
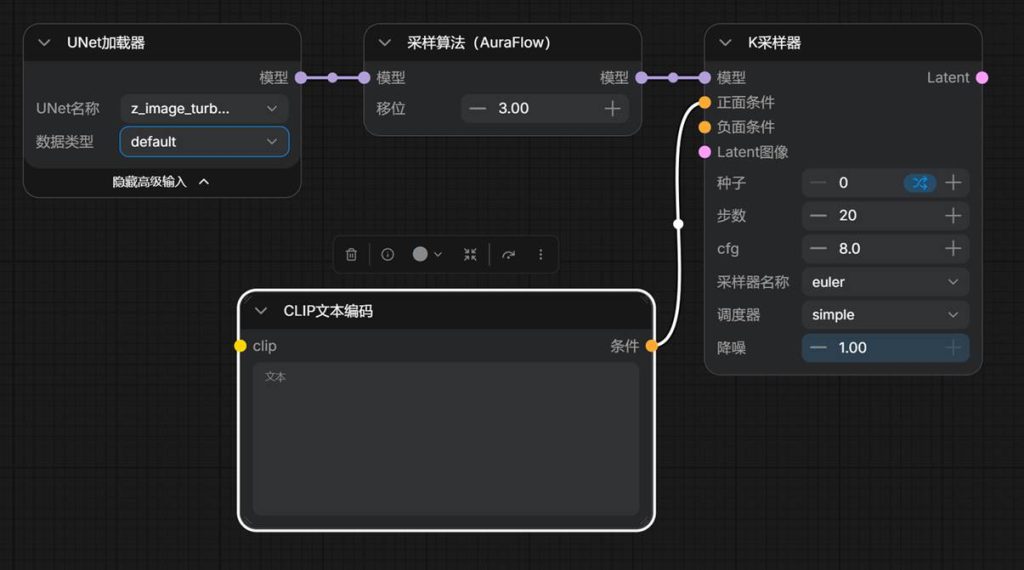
“CLIP文本编码”节点用来写想生成的画面。例如:
一名穿米白色风衣的年轻女性站在雨夜街头,
暖色便利店灯光照亮面部,地面有自然倒影,
真实摄影,浅景深,中景构图,皮肤纹理自然,清晰对焦
在CLIP文本编码的左侧“clip”拉出一条线,选择
加载CLIP(Load CLIP)
选择:
CLIP名称:qwen_3_4b.safetensors
类型:lumina2
设备:default
接着从同一个“条件”(CLIP文本编码)的输出再拉一条线,搜索:
ConditioningZeroOut
条件零化
将条件零化的输出连接到 KSampler 的“负面条件”。
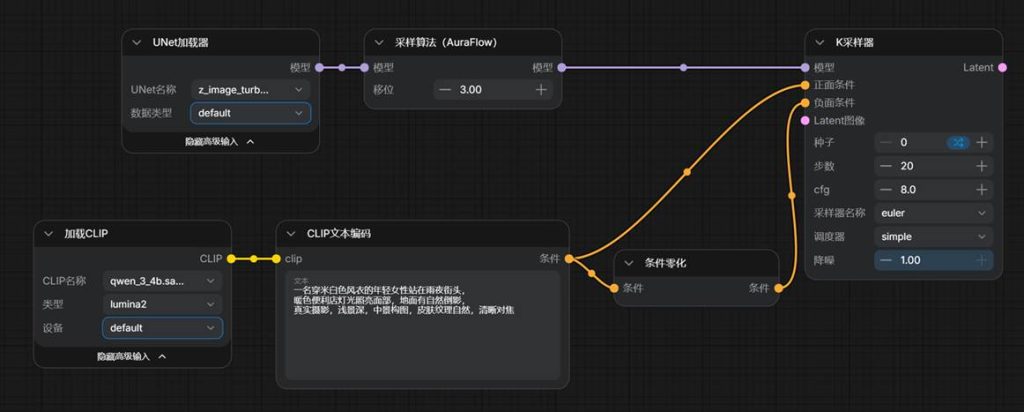
Z-Image-Turbo 不需要传统负向提示词,所以不要再创建第二个文本框去写 bad hands、low quality 等词,而是可以用条件零化代替负向提示词。
第 4 步:添加空 Latent 画布
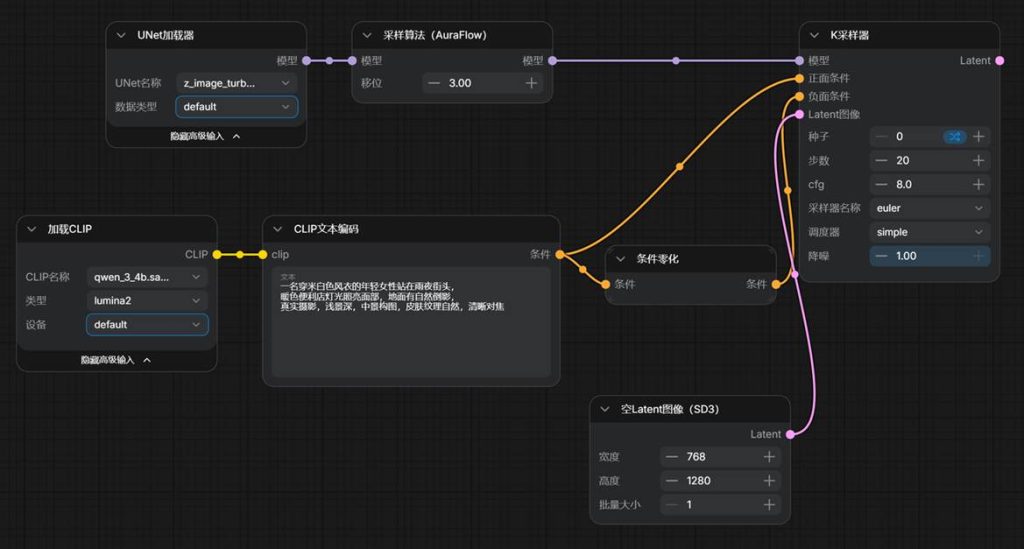
KSampler 还需要一份初始 Latent。Latent 可以理解成 AI 内部使用的“数字画布”:它不是肉眼能看的普通图片,而是一组等待去噪的数字。
搜索并添加:
官方工作流选择:
空Latent图像(SD3)(EmptySD3LatentImage)
或者也可以使用传统的:
空Latent图像(EmptyLatentImage)
把它连接到 KSampler 的 latent_image。
调整图片参数为:
宽度:768
高度:1280
批量大小:1
批量大小表示一次生成几张图。可以先设为 1,否则显存和等待时间都会增加。
第 5 步:用 VAE 把 Latent 解码成图片
KSampler 输出的仍然是 Latent 数据,不能直接当作 PNG 或 JPG 查看。我们需要 VAE 把内部数据“显影”为可见图片。
在KSampler 右侧输出的latent拉一条线,添加:
VAE解码(VAE Decode)
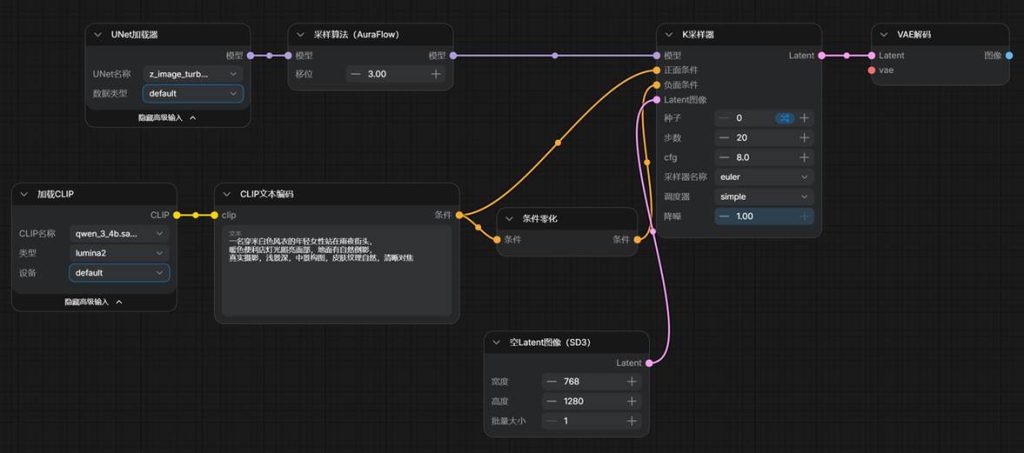
在VAE解码左侧的“VAE”输入中,拉出一条线,添加:
加载VAE(Load VAE)
选择:
ae.safetensors
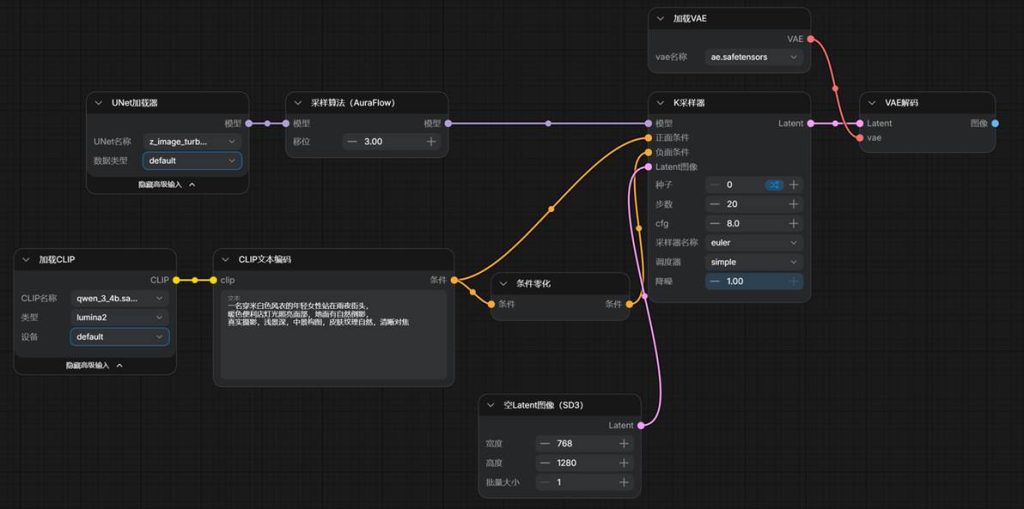
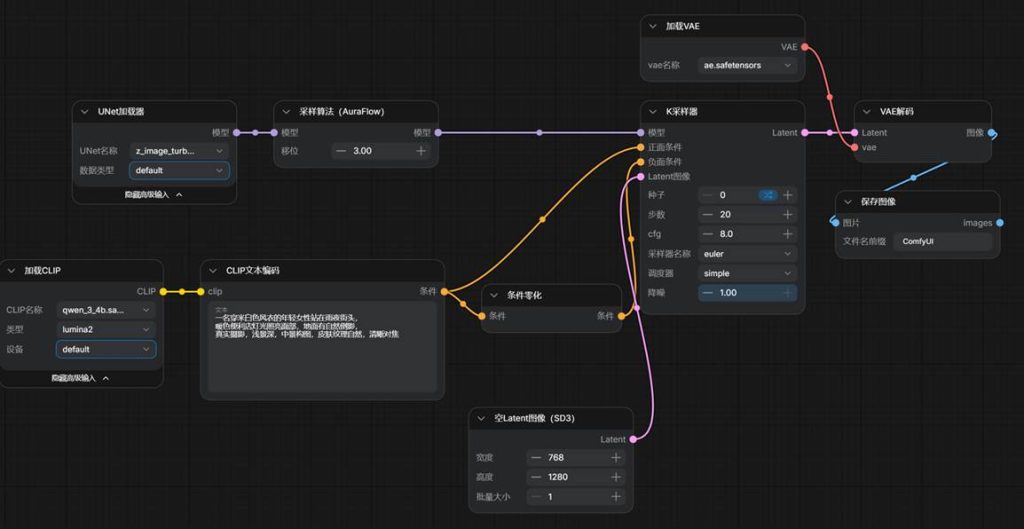
最后从 VAE Decode 的图片输出端拉线,创建:
保存图像(Save Image)
Save Image 默认会把图片放进 ComfyUI 的 output 目录。
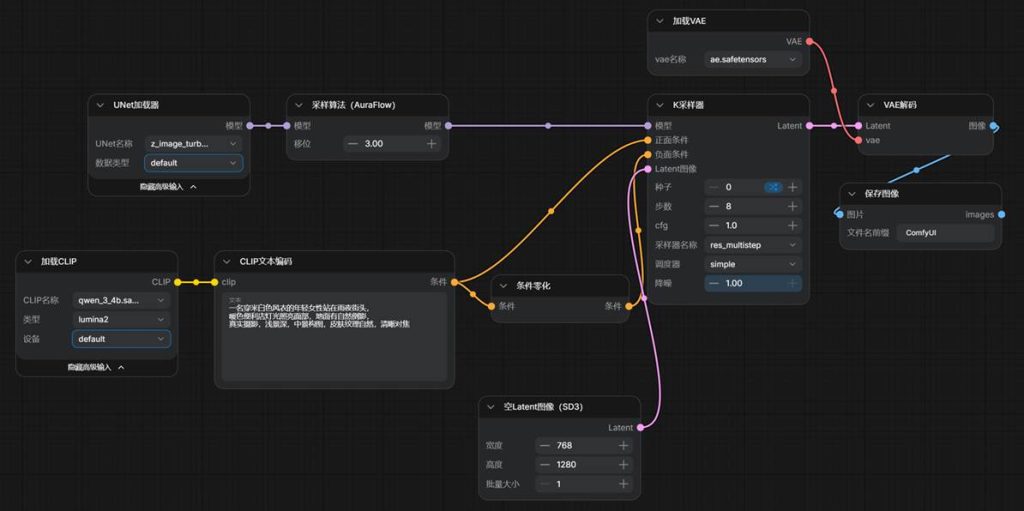
第 6 步:设置采样参数
现在回到 KSampler,设置:
种子:任意整数,或使用随机模式
步骤:8
CFG:1.0
采样器名称:res_multistep
调度器:simple
降噪:1.00
这些参数是一套配合使用的默认组合。建议出图时不要一口气同时改采样器、调度器、步数、CFG、尺寸和提示词,否则结果变化后,你无法判断是哪项设置造成的。
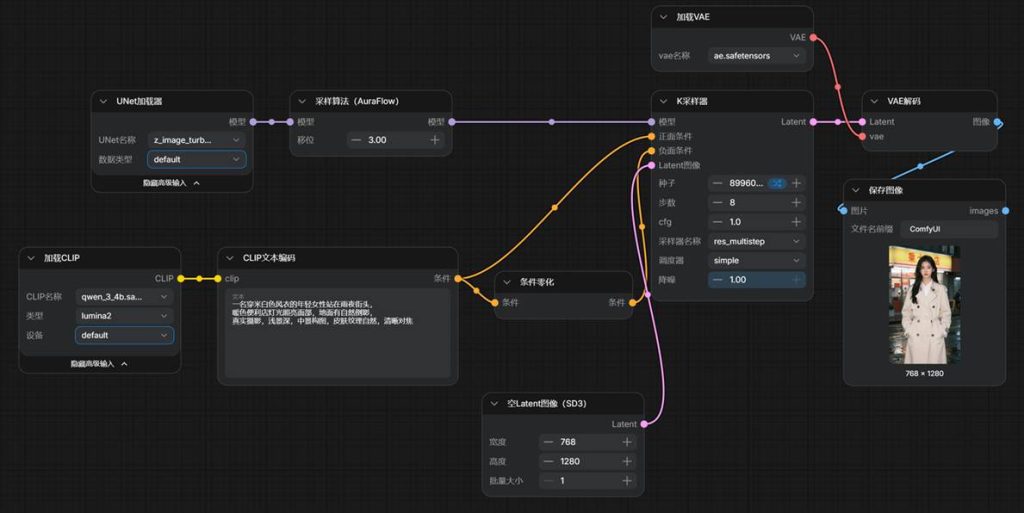
第 7 步:运行第一张图片
点击“运行”,即可生成图片
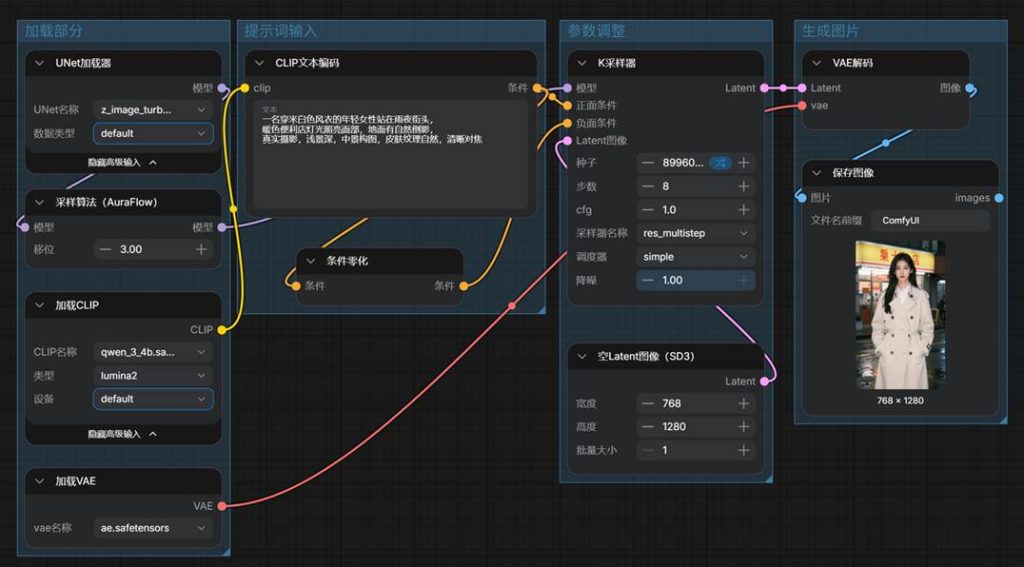
第 8 步:给节点分组
节点越来越多以后,可以按功能分成四组:
- 模型加载;
- 提示词输入;
- 采样参数;
- 解码与保存。
按住 Ctrl 多选或框选相关节点,再按 Ctrl + G 创建分组。不同前端版本的框选方式可能略有不同。
分组不会改变任何生成结果,它只负责让画布更整齐。
第 9 步:对齐节点
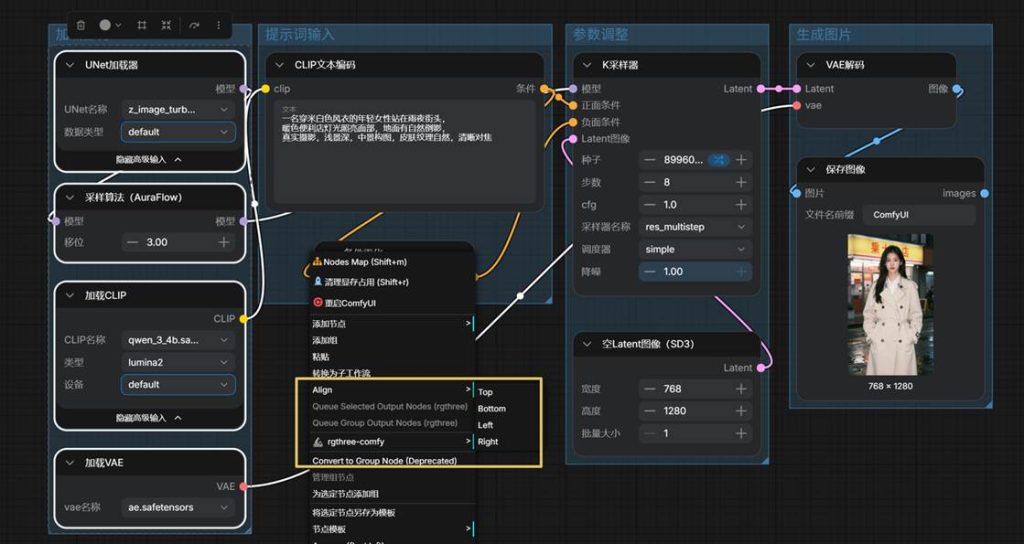
选中多个节点后,在画布空白处打开右键菜单,找到 Align,再选择:
Left 左对齐
Right 右对齐
Top 顶部对齐
Bottom 底部对齐
对齐只改变节点在画布上的位置,不会改变连接和出图结果。
第 10 步:保存工作流
完成后按 Ctrl + S,为工作流输入名称,例如:
Z-Image-Turbo文生图工作流
后续可以按 W 展开工作流侧栏,快速复用工作流。
三、新手怎样写出有效提示词
Z-Image-Turbo 的文本编码器擅长理解自然语言。你不必把提示词写成一串生硬标签,更适合像给摄影师或画师布置任务一样,把画面说清楚。
1. 一个容易使用的提示词顺序
可以按照下面的顺序组织:
主体是谁
+ 在做什么
+ 身处什么环境
+ 画面怎样构图
+ 使用什么光线
+ 想要什么风格和细节
例如:
一只戴红色针织帽的白猫坐在木质窗台上,
窗外正在下雪,远处是暖黄色灯光的小镇,
猫看向窗外,侧面中景构图,柔和自然光,
真实摄影,浅景深,毛发细节清晰,画面安静温暖
这比下面这种堆词方式更容易检查:
masterpiece, best quality, amazing, ultra detailed,
8k, perfect, beautiful, cinematic...
不是说形容词完全不能用,而是“具体看得见的内容”通常比空泛的赞美词更有价值。
2. 不写负向词,怎样避免坏手和模糊
把“不想要什么”改写成“希望看到什么”。例如:
| 不推荐依赖的负向写法 | 更适合 Z-Image-Turbo 的正向写法 |
| bad hands, extra fingers | 双手自然放在桌面上,五根手指清晰可见,手部结构自然 |
| blurry | 主体清晰对焦,面部与眼睛细节清楚 |
| plastic skin | 真实自然的皮肤纹理,柔和光线,保留细微毛孔 |
| bad composition | 人物位于画面中央,中景构图,头顶保留适当空间 |
| wrong text | 招牌清楚写着“春日咖啡”,文字端正、完整、易读 |
负向提示词更像“远离某个方向”,而不是生成完成后的橡皮擦。既然 Z-Image-Turbo 的标准流程不使用传统负向分支,直接描述正确结果会更清楚。
3. 一次只改一项
想比较提示词或参数时,固定以下内容:
- 同一个模型;
- 同一个种子;
- 同一个尺寸;
- 同一套采样参数;
- 只修改一处提示词。
如果种子处于每次随机状态,即使提示词完全相同,两次图片也可能不一样。
扩展阅读
有以上部分,已经足够使用Zimage生图了,以下部分为扩展阅读,如果想进一步了解“参数为什么这样选”,可以阅读后续内容。
在理解具体参数前,可以先用一个统一比喻记住各组件,把整个工作流想象成一家画室:
| 组件 | 实际作用 |
| Qwen3 4B | 把提示词转换成模型可计算的数字条件 |
| Z-Image-Turbo | 根据文字条件从噪声中生成图像 |
| 空 SD3 Latent | 提供生成起点、尺寸和批量大小 |
| KSampler | 组织每一步去噪并收集所需输入 |
| Sampler | 决定从当前位置怎样更新图像 |
| Scheduler | 决定各次更新落在哪些噪声强度上 |
| ModelSamplingAuraFlow | 让调度和采样按照模型期望的时间/噪声刻度工作 |
| Steps | 整个去噪过程安排多少次模型更新 |
| CFG | 决定是否额外放大正负条件之间的差异 |
| VAE | 在潜空间数据和可见图片之间转换 |
最容易混淆的是下面三项:
Sampler 决定每一步怎样算,Scheduler 决定在哪些噪声位置算,ModelSamplingAuraFlow 定义当前模型怎样理解这些噪声位置。
四、Qwen3 4B 明明不是 CLIP,为什么放进“加载CLIP”
1. “CLIP Loader”是历史名称
早期 Stable Diffusion 主要使用 CLIP 理解提示词,所以 ComfyUI 把文本编码器加载节点命名为 CLIPLoader。
后来 ComfyUI 支持了越来越多文本编码器,例如 CLIP、Qwen 等。为了兼容旧工作流,节点名称没有随着每一种模型重新命名。因此现在可以把它理解为:
CLIPLoader 是“文本编码器加载器”这个职位的历史名称,并不表示里面只能装 CLIP 模型。
就像一个文件夹仍叫“照片”,里面也可以放视频;名字保留了历史,用途已经变广。
2. Qwen3 4B 作用是什么
qwen_3_4b.safetensors 是大约 40 亿参数的文本编码器。它擅长理解中文、英文和较长指令。
例如你写:
一名年轻女性站在雨夜街头,暖色便利店灯光,真实摄影,浅景深
它会把文字转换成包含人物、地点、天气、光线、风格等含义的高维数字,再把这些数字交给 Z-Image-Turbo。真正从噪声中生成画面的,是扩散主模型。
3. 为什么类型选 lumina2
CLIPLoader 中的 type 是在告诉 ComfyUI:
应该使用哪一套程序结构和数据格式读取这个文本编码器。
可以把模型文件想象成一本外文书:
- clip_name 决定拿哪一本书;
- type 决定使用哪一种语言规则读这本书。
Z-Image-Turbo 的官方 ComfyUI 模板选择为 lumina2。这表示 ComfyUI 当前通过这套兼容路径正确封装 Z-Image 所需的文本条件,建议新手直接遵循官方模板即可。
五、为什么 Steps 是 8,而不是越多越好
1. 普通模型和 Turbo 模型的区别
普通扩散模型可能需要 20~50 步,逐渐把噪声修成清晰画面:
噪声
→ 出现大致构图
→ 出现人物轮廓
→ 补充颜色与光影
→ 完善纹理和细节
Z-Image-Turbo 经过了面向快速推理的蒸馏训练。可以把蒸馏理解成:
老师原来需要很多步骤完成任务,现在把这套经验教给学生,让学生用少数几步完成相近结果。
官方把 Turbo 版本设计为大约 8 次模型计算完成生成,所以 Steps=8 不是“显卡不够才少跑几步”,而是与它的训练方式相匹配。
2. 增加到 20、30 步会怎样
不一定更好。盲目增加步数可能出现:
- 速度明显变慢;
- 细节没有相应提升;
- 纹理过硬或过度加工;
- 色彩和光影发生不需要的变化;
- 生成轨迹偏离模型蒸馏时习惯的路线。
可以把它理解为方便面说明写“煮 3 分钟”:煮 30 分钟并不会更高级,反而可能破坏原本状态。
六、CFG、负向提示词和条件零化,一次讲清楚
这部分是原工作流最容易被误解、也最容易反复解释的地方。先给结论:
- Z-Image-Turbo 的 ComfyUI 标准工作流使用 CFG=1。
- 它不使用传统负向提示词。
- ConditioningZeroOut 给 KSampler 提供一个结构合法、内容归零的负向占位条件。
- 在标准 KSampler 且没有自定义 Guider 的情况下,CFG=1 会跳过负向预测。
1. CFG 的全名是什么意思
CFG 是 Classifier-Free Guidance 的缩写,常译为“无分类器引导”。
这个名字要拆开理解。
Classifier:分类器
分类器是一种判断图片内容的模型。例如它看到一张图片后,可能输出:
猫:90%
狗:5%
汽车:1%
其他:4%
早期的 Classifier Guidance 会在生成模型之外,再准备一个分类器检查半成品图片像不像目标内容,然后用分类器给出的方向推动生成。
Free:不依赖
这里的 Free 不是“免费”,也不是“自由发挥”,而是:
free from a classifier
= 不依赖额外的分类器
Guidance:引导
Guidance 表示给生成过程一个更明确的方向,让图片更符合提示词。
所以完整含义是:
不额外训练一名“图片分类老师”,而让生成模型自己给出有条件和无条件两种预测,再利用两者的差异加强提示词方向。
2. 传统 CFG 为什么要计算两次
在传统 CFG 中,同一个模型通常要回答两个问题。
第一次是无条件预测:
不告诉你具体提示词,根据当前噪声,下一步应该怎样去噪?
第二次是有条件预测:
现在告诉你要画“一只戴红色帽子的白猫”,下一步应该怎样去噪?
训练这类模型时,会有意让模型在一部分训练样本中看不到文字条件。这样,同一个模型既学会有条件预测,也学会无条件预测,不需要另找一个分类器。
后来实际使用中,人们常用真正的负向提示词替换空条件,于是“无条件分支”也经常被称为 negative 分支。更准确地说,它是 CFG 公式的基准分支:可以是空文本、负向文本,也可以是经过零化的条件。
对于使用传统 CFG 的模型,数值可以用下面这张表辅助理解,但它不是所有模型通用的参数推荐:
| 传统 CFG 数值 | 公式中的含义 | 常见现象 |
| 0 | 只保留基准或负向分支 | 通常不会正常遵循正向提示词 |
| 1 | 正好等于正向预测 | 不额外强化,标准 KSampler 可跳过负向分支 |
| 2~4 | 轻度放大提示词方向 | 画面通常较自然,服从度有所提高 |
| 5~8 | 明显放大提示词方向 | 传统 SD/SDXL 工作流中的常见区间之一 |
| 10 以上 | 非常强的放大 | 更容易过饱和、锐化、失真并降低多样性 |
传统 CFG 的价值,是在提示词符合度、画面质量和结果多样性之间进行取舍。它解决的是单独条件预测可能没有充分表现提示词中每一项要求的问题,而不是越高越好。
3. CFG 公式到底在做什么
为了方便理解,可以把标准形式写成:
最终预测负向预测正向预测负向预测
真实预测是巨大的多维张量,不是一个普通数字。下面只是帮助理解的例子。
假设:
正向预测 = 10
负向预测 = 4
当 CFG=1:
4 + 1 × (10 - 4)
= 4 + 6
= 10
最终结果正好等于正向预测,负向预测一加一减完全抵消。
当 CFG=2:
4 + 2 × (10 - 4)
= 16
结果不只走到正向预测的 10,还继续沿着“远离负向、靠近正向”的方向前进。
因此,传统 CFG 不是简单地“听提示词多少”,更准确地说,它会放大正向条件相对于基准条件造成的变化方向。
4. 为什么 CFG=1 时负向提示词没有作用
因为公式已经化简成:
最终预测正向预测
程序如果仍然把负向分支完整计算一遍,最后却把它完全抵消,就白白浪费了一次模型运算。因此,ComfyUI 的标准采样流程会在 CFG 为 1 时跳过负向预测,以节省时间和显存。
这意味着在本文的标准工作流中,即使你给负向接口接了一个写满内容的文本编码节点,它通常也不会改变结果。
需要保留“标准工作流”这个前提。如果使用自定义 Guider、特殊插件、修改过的采样逻辑或关闭 CFG=1 优化,行为可能不同。
5. 条件零化到底做了什么
提示词经过 Qwen3 编码以后,已经不再是一句话,而是一组很大的数字。假设为了比喻,它看起来像:
[0.17, -0.42, 0.08, 0.91, ...]
ConditioningZeroOut 会复制条件的数据结构,再把主要条件张量归零。存在需要同步处理的附加条件时,也会按节点实现进行零化。
可以把它想象成一张格式正确的答题卡:
- 正常提示词:答题卡上有完整答案;
- 空文本编码:仍让文本编码器处理了一次空字符串;
- 条件零化:保留合格的答题卡格式,但把答案内容明确改成零。
它有三个实际优点:
- 条件尺寸和数据结构与正向条件匹配;
- 明确表达“这里故意没有负向语义”,不是忘了填写;
- 不需要让 Qwen3 再编码一次空字符串。
它的主要价值是结构清楚和计算简洁,不是额外提升画质。
七、Res Multistep、Euler 和 Simple 分别是什么
1. Sampler 决定“每一步怎样走”
生成图片时,模型要从噪声逐步走向完整图像。Sampler 是数值求解方法,负责根据模型当前预测,计算下一步怎样更新 Latent。
可以把去噪想象成在山里下山:
- 当前位置是当前噪声状态;
- 终点是完整图片;
- Sampler 决定每次怎样迈步和修正方向。
2. Euler 像每一步都重新看方向
Euler 的思路简单直接:
查看当前位置
→ 根据当前预测估计方向
→ 向前走一步
→ 到新位置后重新判断
它的优点是简单、快速、兼容模型多,也很适合作为对照实验。缺点是它主要根据当前一步的局部信息前进,在极少步数下不一定最适合所有模型。
3. Res Multistep 的名字是什么意思
名字可以拆成:
Res + Multi + Step
这里的 Res 与 residual(残差)有关。残差可以粗略理解为“当前状态与预测目标之间还差多少”。
Multistep 表示计算新一步时,会利用前面步骤保存的预测信息,而不是只看当前一步。
可以这样比较:
Euler:
只看眼前方向,走一步后再看
Res Multistep:
看眼前方向,同时参考刚才几步的行走记录
ComfyUI 的相关实现来自残差多步求解思路,第一步还没有历史信息时会采用适合启动的步骤;有历史记录后,再利用前面的估计进行更新。
4. Res Multistep 一定比 Euler 好吗
不一定存在对所有提示词都最好的采样器。不同采样器可能改变:
- 构图;
- 纹理;
- 锐度;
- 色彩;
- 面部细节;
- 随机变化方式。
res_multistep 的意义是它与当前官方 Z-Image-Turbo 少步数配置配套,适合作为新手的起点。如果想比较 Euler,可以固定种子、提示词、尺寸、步数、CFG 和调度器,只修改 Sampler:
res_multistep + simple
对比
euler + simple
6. Scheduler 决定“在哪些位置走”
Scheduler 不负责判断画面应该往哪个方向变化,而是安排每次更新对应的噪声强度或时间位置。
即使都是 8 步,不同调度器也可能把更新机会集中在不同区间,因此会影响构图、细节、锐度和最终收尾。
simple 是当前官方模板使用的调度器。新手可以先保持它不变。
八、ModelSamplingAuraFlow 和 shift=3 到底在做什么
ModelSamplingAuraFlow 接收和输出的都是 MODEL,因此它需要接在模型分支,而不是接到图片、提示词或 VAE 上。
Load Diffusion Model
→ ModelSamplingAuraFlow
→ KSampler
1. 正确理解三个层次
可以用“坐标系统、站点和驾驶方法”来理解:
- ModelSamplingAuraFlow:定义这张地图使用什么坐标系统;
- Scheduler:在这个坐标系统中安排 8 个停靠位置;
- Sampler:决定从一个位置到下一个位置怎样更新。
ModelSamplingAuraFlow 先修改模型对象中的采样规则,KSampler 和 Scheduler 随后依据这套规则工作。
2. shift=3 的数学含义
ComfyUI 使用的时间/SNR 映射可以简化写成:
新位置原位置原位置
当 shift=1 时:
新位置 = 原位置
采样刻度不重新分配。
当 shift=3 时:
| 原始位置 | 映射后位置 |
| 0.25 | 0.50 |
| 0.50 | 0.75 |
| 0.75 | 0.90 |
这表示相同的基础位置,会被映射到不同的模型内部时间或噪声位置。
3. 为什么需要这个节点
没有它时,KSampler 仍可以运行,但模型对各个噪声阶段的理解可能与训练或官方模板不一致,最终画面可能有变化。
九、什么时候用“UNet加载器”,什么时候用“加载 Checkpoint”
先记住最实用的判断:
不是看模型文件有多大,也不是看扩展名,而是看文件里面装了什么。
1. Checkpoint 像一体机
Load Checkpoint 或“加载检查点”会尝试从同一个文件中取出:
MODEL:负责去噪生成
CLIP:负责理解提示词
VAE:负责潜空间与图片互转
典型连接是:
Load Checkpoint
├─ MODEL → KSampler
├─ CLIP → Text Encode
└─ VAE → VAE Encode / Decode
这类文件通常放在:
ComfyUI/models/checkpoints/
传统 SD1.5、SDXL 和许多专门打包的一体化模型经常采用这种形式。
2. UNet加载器像组装电脑
UNet加载器 通常只加载:
MODEL:负责去噪生成的主模型
文本编码器和 VAE 需要另外加载:
UNet加载器 → MODEL
加载CLIP → CLIP
加载VAE → VAE
这正是 Z-Image-Turbo 的情况。三个部件分别下载、分别放目录、分别通过节点加载。
3. 为什么不能只看 .safetensors
Checkpoint、主扩散模型、文本编码器、VAE 和 LoRA 都可能使用 .safetensors 扩展名。扩展名只说明文件采用 Safetensors 存储格式,不说明里面装的是哪类模型。
下面这些文件扩展名相同,角色却完全不同:
z_image_turbo_bf16.safetensors → 主扩散模型
qwen_3_4b.safetensors → 文本编码器
ae.safetensors → VAE
4. 三种可靠判断方法
方法一:看官方工作流
官方使用:
Load Checkpoint
通常就按一体化 Checkpoint 处理。
官方使用:
UNET Loader
Load CLIP
Load VAE
通常就按分离组件处理。
这是最可靠的方法。
方法二:看需要下载几个核心文件
如果说明明确告诉你一个文件同时包含 MODEL、CLIP 和 VAE,使用 Load Checkpoint。
如果主模型、文本编码器和 VAE 分别下载,使用对应的三个加载节点。
方法三:看官方要求放入哪个目录
| 官方要求的目录 | 通常对应的加载器 |
| models/checkpoints/ | Load Checkpoint |
| models/diffusion_models/ | UNET Loader |
| models/text_encoders/ | Load CLIP / DualCLIP |
| models/vae/ | Load VAE |
目录不是模型原理本身,但官方指定的目录通常与加载节点直接对应